Brings SummarizedExperiment to the tidyverse!
website: stemangiola.github.io/tidySummarizedExperiment/
Another nice introduction by carpentries-incubator.
Please also have a look at
- tidySingleCellExperiment for tidy manipulation of SingleCellExperiment objects
- tidyseurat for tidy manipulation of Seurat objects
- tidybulk for tidy analysis of RNA sequencing data
- nanny for tidy high-level data analysis and manipulation
- tidygate for adding custom gate information to your tibble
- tidyHeatmap for heatmaps produced with tidy principles
Introduction
tidySummarizedExperiment provides a bridge between Bioconductor SummarizedExperiment [@morgan2020summarized] and the tidyverse [@wickham2019welcome]. It creates an invisible layer that enables viewing the Bioconductor SummarizedExperiment object as a tidyverse tibble, and provides SummarizedExperiment-compatible dplyr, tidyr, ggplot and plotly functions. This allows users to get the best of both Bioconductor and tidyverse worlds.
Functions/utilities available
| SummarizedExperiment-compatible Functions | Description |
|---|---|
all |
After all tidySummarizedExperiment is a SummarizedExperiment object, just better |
| tidyverse Packages | Description |
|---|---|
dplyr |
Almost all dplyr APIs like for any tibble |
tidyr |
Almost all tidyr APIs like for any tibble |
ggplot2 |
ggplot like for any tibble |
plotly |
plot_ly like for any tibble |
| Utilities | Description |
|---|---|
as_tibble |
Convert cell-wise information to a tbl_df
|
Installation
if (!requireNamespace("BiocManager", quietly=TRUE)) {
      install.packages("BiocManager")
  }

BiocManager::install("tidySummarizedExperiment")
From Github (development)
devtools::install_github("stemangiola/tidySummarizedExperiment")Load libraries used in the examples.
library(ggplot2)
library(tidySummarizedExperiment)
tidy_print_on(remember = TRUE)
tidySummarizedExperiment, the best of both worlds!
This is a SummarizedExperiment object, but it becomes fully compatible with both SummarizedExperiment and tidyverse APIs.
pasilla <- tidySummarizedExperiment::pasilla It looks like a tibble
pasilla##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=14599 | Samples=7 |
[0m
## #
[90m Assays=counts
[0m
[39m
##
[90m#
[94m |------ COVARIATES ----|
[0m
[39m
## .feature .sample | counts | condition type |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m |
[3m
[90m<chr>
[39m
[23m |
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m |
##
[90m1
[39m FBgn0000003 untrt1 | 0 | untreated single_end |
##
[90m2
[39m FBgn0000008 untrt1 | 92 | untreated single_end |
##
[90m3
[39m FBgn0000014 untrt1 | 5 | untreated single_end |
##
[90m4
[39m FBgn0000015 untrt1 | 0 | untreated single_end |
##
[90m5
[39m FBgn0000017 untrt1 | 4664 | untreated single_end |
##
[90m
[39m -------- ------- - ------ - --------- ---- -
##
[90m102189
[39m FBgn0261571 trt3 | 0 | treated paired_end |
##
[90m102190
[39m FBgn0261572 trt3 | 3 | treated paired_end |
##
[90m102191
[39m FBgn0261573 trt3 | 1908 | treated paired_end |
##
[90m102192
[39m FBgn0261574 trt3 | 3047 | treated paired_end |
##
[90m102193
[39m FBgn0261575 trt3 | 4 | treated paired_end |But it is a SummarizedExperiment object after all
assays(pasilla)Tidyverse commands
We can use tidyverse commands to explore the tidy SummarizedExperiment object.
We can use slice to choose rows by position, for example to choose the first row.
##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=1 | Samples=1 |
[0m
## #
[90m  Assays=counts
[0m
[39m
##
[90m#
[94m                             |------ COVARIATES ----|
[0m
[39m
##   .feature    .sample | counts | condition type       |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m   |
[3m
[90m<int>
[39m
[23m |
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m      |
##
[90m1
[39m FBgn0000003 untrt1  |      0 | untreated single_end |
We can use filter to choose rows by criteria.
##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=14599 | Samples=4 |
[0m
## #
[90m  Assays=counts
[0m
[39m
##
[90m#
[94m                                 |------ COVARIATES ----|
[0m
[39m
##       .feature    .sample | counts | condition type       |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m   |
[3m
[90m<chr>
[39m
[23m  |
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m      |
##
[90m1
[39m FBgn0000003 untrt1  | 0      | untreated single_end |
##
[90m2
[39m FBgn0000008 untrt1  | 92     | untreated single_end |
##
[90m3
[39m FBgn0000014 untrt1  | 5      | untreated single_end |
##
[90m4
[39m FBgn0000015 untrt1  | 0      | untreated single_end |
##
[90m5
[39m FBgn0000017 untrt1  | 4664   | untreated single_end |
##
[90m
[39m --------    ------- - ------ - --------- ----       -
##
[90m58392
[39m FBgn0261571 untrt4  | 0      | untreated paired_end |
##
[90m58393
[39m FBgn0261572 untrt4  | 11     | untreated paired_end |
##
[90m58394
[39m FBgn0261573 untrt4  | 1612   | untreated paired_end |
##
[90m58395
[39m FBgn0261574 untrt4  | 2819   | untreated paired_end |
##
[90m58396
[39m FBgn0261575 untrt4  | 3      | untreated paired_end |
We can use select to choose columns.
##
[90m# A tibble: 102,193 × 1
[39m
##    .sample
##
[3m
[90m<chr>
[39m
[23m
##
[90m 1
[39m untrt1
##
[90m 2
[39m untrt1
##
[90m 3
[39m untrt1
##
[90m 4
[39m untrt1
##
[90m 5
[39m untrt1
##
[90m 6
[39m untrt1
##
[90m 7
[39m untrt1
##
[90m 8
[39m untrt1
##
[90m 9
[39m untrt1
##
[90m10
[39m untrt1
##
[90m# ℹ 102,183 more rows
[39m
We can use count to count how many rows we have for each sample.
##
[90m# A tibble: 7 × 2
[39m
##   .sample     n
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<int>
[39m
[23m
##
[90m1
[39m trt1
[4m1
[24m
[4m4
[24m599
##
[90m2
[39m trt2
[4m1
[24m
[4m4
[24m599
##
[90m3
[39m trt3
[4m1
[24m
[4m4
[24m599
##
[90m4
[39m untrt1
[4m1
[24m
[4m4
[24m599
##
[90m5
[39m untrt2
[4m1
[24m
[4m4
[24m599
##
[90m6
[39m untrt3
[4m1
[24m
[4m4
[24m599
##
[90m7
[39m untrt4
[4m1
[24m
[4m4
[24m599
We can use distinct to see what distinct sample information we have.
##
[90m# A tibble: 7 × 3
[39m
##   .sample condition type
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m
##
[90m1
[39m untrt1  untreated single_end
##
[90m2
[39m untrt2  untreated single_end
##
[90m3
[39m untrt3  untreated paired_end
##
[90m4
[39m untrt4  untreated paired_end
##
[90m5
[39m trt1    treated   single_end
##
[90m6
[39m trt2    treated   paired_end
##
[90m7
[39m trt3    treated   paired_end
We could use rename to rename a column. For example, to modify the type column name.
##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=14599 | Samples=7 |
[0m
## #
[90m  Assays=counts
[0m
[39m
##
[90m#
[94m                                  |------ COVARIATES ----|
[0m
[39m
##        .feature    .sample | counts | condition sequencing |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m   |
[3m
[90m<chr>
[39m
[23m  |
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m      |
##
[90m1
[39m FBgn0000003 untrt1  | 0      | untreated single_end |
##
[90m2
[39m FBgn0000008 untrt1  | 92     | untreated single_end |
##
[90m3
[39m FBgn0000014 untrt1  | 5      | untreated single_end |
##
[90m4
[39m FBgn0000015 untrt1  | 0      | untreated single_end |
##
[90m5
[39m FBgn0000017 untrt1  | 4664   | untreated single_end |
##
[90m
[39m --------    ------- - ------ - --------- ---------- -
##
[90m102189
[39m FBgn0261571 trt3    | 0      | treated   paired_end |
##
[90m102190
[39m FBgn0261572 trt3    | 3      | treated   paired_end |
##
[90m102191
[39m FBgn0261573 trt3    | 1908   | treated   paired_end |
##
[90m102192
[39m FBgn0261574 trt3    | 3047   | treated   paired_end |
##
[90m102193
[39m FBgn0261575 trt3    | 4      | treated   paired_end |
We could use mutate to create a column. For example, we could create a new type column that contains single and paired instead of single_end and paired_end.
##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=14599 | Samples=7 |
[0m
## #
[90m  Assays=counts
[0m
[39m
##
[90m#
[94m                                  |---- COVARIATES --|
[0m
[39m
##        .feature    .sample | counts | condition type   |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m   |
[3m
[90m<chr>
[39m
[23m  |
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m  |
##
[90m1
[39m FBgn0000003 untrt1  | 0      | untreated single |
##
[90m2
[39m FBgn0000008 untrt1  | 92     | untreated single |
##
[90m3
[39m FBgn0000014 untrt1  | 5      | untreated single |
##
[90m4
[39m FBgn0000015 untrt1  | 0      | untreated single |
##
[90m5
[39m FBgn0000017 untrt1  | 4664   | untreated single |
##
[90m
[39m --------    ------- - ------ - --------- ----   -
##
[90m102189
[39m FBgn0261571 trt3    | 0      | treated   paired |
##
[90m102190
[39m FBgn0261572 trt3    | 3      | treated   paired |
##
[90m102191
[39m FBgn0261573 trt3    | 1908   | treated   paired |
##
[90m102192
[39m FBgn0261574 trt3    | 3047   | treated   paired |
##
[90m102193
[39m FBgn0261575 trt3    | 4      | treated   paired |
We could use unite to combine multiple columns into a single column.
##
[90m# A SummarizedExperiment-tibble abstraction:
[90mFeatures=14599 | Samples=7 |
[0m
## #
[90m  Assays=counts
[0m
[39m
##
[90m#
[94m                                  |------ COVARIATES ----|
[0m
[39m
##        .feature    .sample | counts | group                |
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m   |
[3m
[90m<chr>
[39m
[23m  |
[3m
[90m<chr>
[39m
[23m                |
##
[90m1
[39m FBgn0000003 untrt1  | 0      | untreated_single_end |
##
[90m2
[39m FBgn0000008 untrt1  | 92     | untreated_single_end |
##
[90m3
[39m FBgn0000014 untrt1  | 5      | untreated_single_end |
##
[90m4
[39m FBgn0000015 untrt1  | 0      | untreated_single_end |
##
[90m5
[39m FBgn0000017 untrt1  | 4664   | untreated_single_end |
##
[90m
[39m --------    ------- - ------ - -----                -
##
[90m102189
[39m FBgn0261571 trt3    | 0      | treated_paired_end   |
##
[90m102190
[39m FBgn0261572 trt3    | 3      | treated_paired_end   |
##
[90m102191
[39m FBgn0261573 trt3    | 1908   | treated_paired_end   |
##
[90m102192
[39m FBgn0261574 trt3    | 3047   | treated_paired_end   |
##
[90m102193
[39m FBgn0261575 trt3    | 4      | treated_paired_end   |
We can also combine commands with the tidyverse pipe %>%.
For example, we could combine group_by and summarise to get the total counts for each sample.
##
[90m# A tibble: 7 × 2
[39m
##   .sample total_counts
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<int>
[39m
[23m
##
[90m1
[39m trt1        18
[4m6
[24m
[4m7
[24m
[4m0
[24m279
##
[90m2
[39m trt2         9
[4m5
[24m
[4m7
[24m
[4m1
[24m826
##
[90m3
[39m trt3        10
[4m3
[24m
[4m4
[24m
[4m3
[24m856
##
[90m4
[39m untrt1      13
[4m9
[24m
[4m7
[24m
[4m2
[24m512
##
[90m5
[39m untrt2      21
[4m9
[24m
[4m1
[24m
[4m1
[24m438
##
[90m6
[39m untrt3       8
[4m3
[24m
[4m5
[24m
[4m8
[24m426
##
[90m7
[39m untrt4       9
[4m8
[24m
[4m4
[24m
[4m1
[24m335
We could combine group_by, mutate and filter to get the transcripts with mean count > 0.
##
[90m# A tibble: 86,513 × 6
[39m
##
[90m# Groups:   .feature [12,359]
[39m
##    .feature    .sample counts condition type       mean_count
##
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m
[3m
[90m<int>
[39m
[23m
[3m
[90m<chr>
[39m
[23m
[3m
[90m<chr>
[39m
[23m
[3m
[90m<dbl>
[39m
[23m
##
[90m 1
[39m FBgn0000003 untrt1       0 untreated single_end      0.143
##
[90m 2
[39m FBgn0000008 untrt1      92 untreated single_end     99.6
##
[90m 3
[39m FBgn0000014 untrt1       5 untreated single_end      1.43
##
[90m 4
[39m FBgn0000015 untrt1       0 untreated single_end      0.857
##
[90m 5
[39m FBgn0000017 untrt1
[4m4
[24m664 untreated single_end
[4m4
[24m672.
##
[90m 6
[39m FBgn0000018 untrt1     583 untreated single_end    461.
##
[90m 7
[39m FBgn0000022 untrt1       0 untreated single_end      0.143
##
[90m 8
[39m FBgn0000024 untrt1      10 untreated single_end      7
##
[90m 9
[39m FBgn0000028 untrt1       0 untreated single_end      0.429
##
[90m10
[39m FBgn0000032 untrt1
[4m1
[24m446 untreated single_end
[4m1
[24m085.
##
[90m# ℹ 86,503 more rows
[39m
Plotting
my_theme <-
    list(
        scale_fill_brewer(palette="Set1"),
        scale_color_brewer(palette="Set1"),
        theme_bw() +
            theme(
                panel.border=element_blank(),
                axis.line=element_line(),
                panel.grid.major=element_line(size=0.2),
                panel.grid.minor=element_line(size=0.1),
                text=element_text(size=12),
                legend.position="bottom",
                aspect.ratio=1,
                strip.background=element_blank(),
                axis.title.x=element_text(margin=margin(t=10, r=10, b=10, l=10)),
                axis.title.y=element_text(margin=margin(t=10, r=10, b=10, l=10))
            )
    )
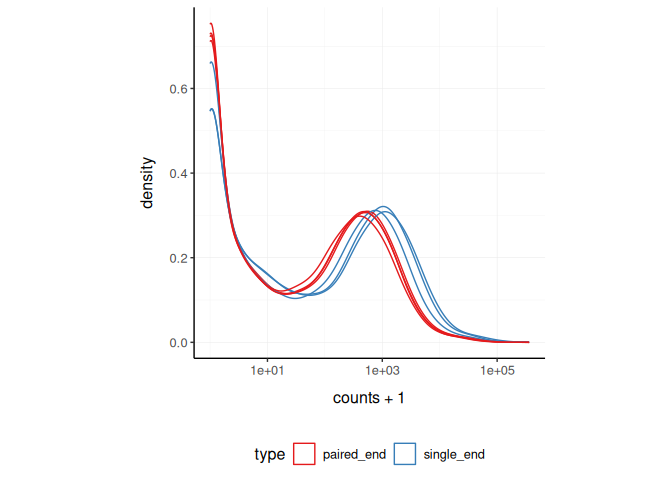
We can treat pasilla as a normal tibble for plotting.
Here we plot the distribution of counts per sample.
pasilla %>%
    ggplot(aes(counts + 1, group=.sample, color=`type`)) +
    geom_density() +
    scale_x_log10() +
    my_theme